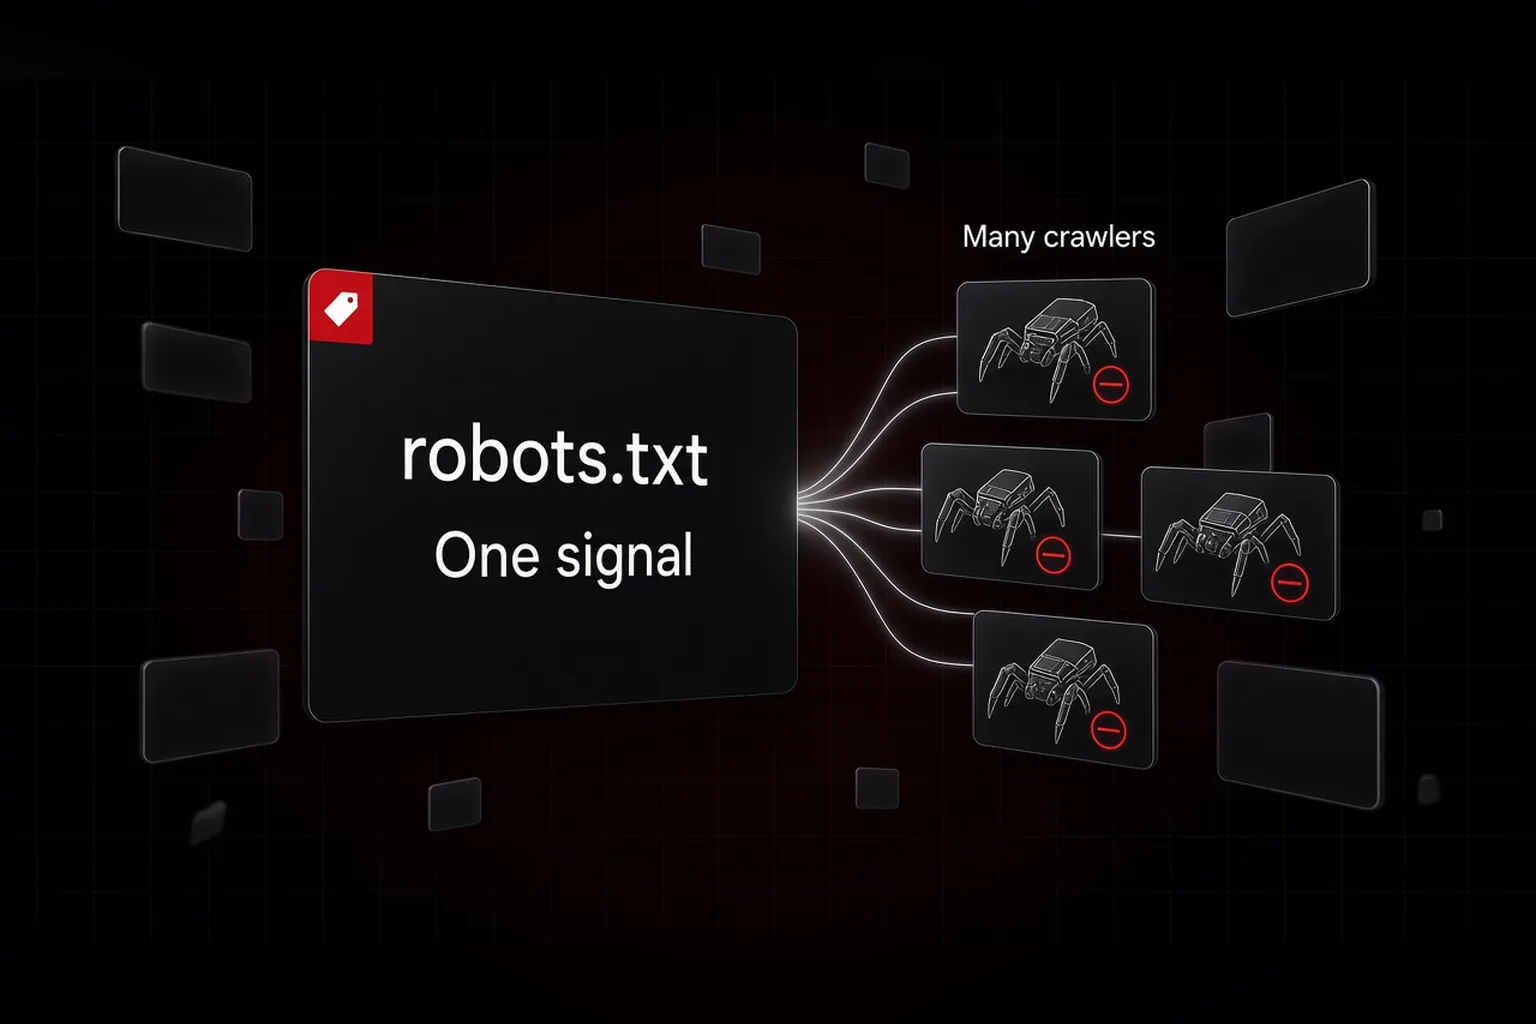
OpenAI, Google, Microsoft und Anthropic wollen ein gemeinsames Signal in robots.txt beachten, mit dem Websitebetreiber festlegen, ob ihre Inhalte für KI-Training genutzt werden dürfen, berichtete The Verge am 30. Oktober 2026. Bisher mussten Websites diese Vorgaben für die Crawler jedes Unternehmens einzeln setzen.
Das Signal ist ein „Policy-Token“, das Kevin Kelley, technischer Leiter für Standards bei Anthropic, in der Internet Engineering Task Force vorgeschlagen hat. Es baut auf der Arbeit der IETF-Arbeitsgruppe zu KI-Präferenzen auf. In seiner eigenen Mitteilung schreibt OpenAI, das Signal betreffe die Nutzung von Inhalten für das Training grundlegender generativer KI-Modelle und ersetze nicht die bestehenden Crawler-Einstellungen von OpenAI, die weiter gelten.
Der Zeitplan unterscheidet sich. Anthropic hat das Signal bereits eingeführt. OpenAI will es „in den kommenden Monaten“ umsetzen und dann Details veröffentlichen. Google und Microsoft planen die Unterstützung für nächstes Jahr. Microsoft will getrennte Opt-outs für KI-Training und für KI-Grounding anbieten, also die Nutzung einer Seite als Quelle für Antworten, und Websites erscheinen unabhängig von ihrer Wahl weiter in den Bing-Suchergebnissen. Metas Kommunikationschef Andy Stone signalisierte Unterstützung, sagte aber nicht, ob Meta das Signal beachten wird.
Die Initiative ist freiwillig. Wie alles in robots.txt wirkt sie nur bei Crawlern, die die Datei respektieren. Zudem betrifft sie das Training, also nur eine von mehreren Nutzungen. Microsofts Trennung von Training und Grounding zeigt die Grenze: Eine Seite zum Aufbau eines Modells zu verwenden und sie abzurufen, um eine Frage zu beantworten, sind unterschiedliche Nutzungen mit unterschiedlicher Wirkung auf den Traffic.
Warum das für Websitebetreiber wichtig ist
Für eine Unternehmenswebsite könnte eine Zeile in robots.txt bald eine Liste von Crawler-Namen ersetzen, die sich alle paar Monate ändert. Die Entscheidung selbst bleibt: ob Training erlaubt wird und, getrennt davon, ob die Website in der Suche und in KI-Antworten sichtbar bleibt. Die genaue Syntax wird wichtig, sobald die Anbieter ihre Umsetzung veröffentlichen. Bis dahin bleiben die bestehenden Regeln pro Crawler das wirksame Werkzeug.
Dieser Artikel ist keine Rechtsberatung.