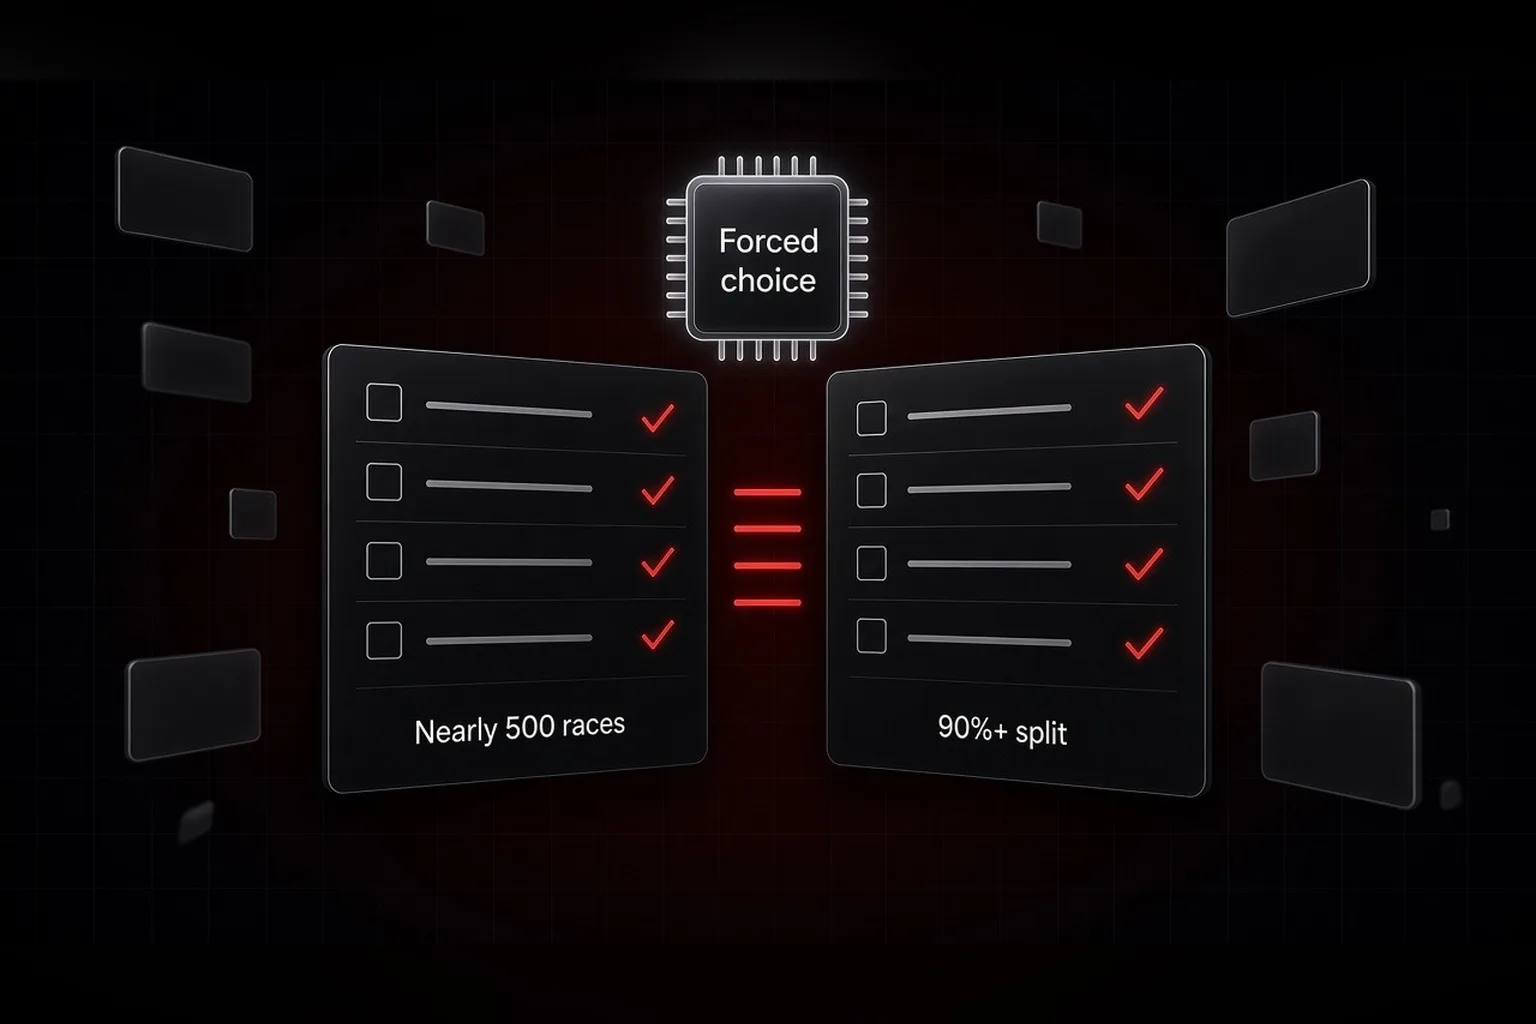
Grok und OpenAIs GPT empfahlen laut einer von TechCrunch aufgegriffenen Studie in mehr als 90 % von fast 500 Wahlkämpfen unterschiedliche Kandidaten. Grok entschied sich überwiegend für Republikaner, GPT bevorzugte Demokraten.
Beide bekannten KI-Modelle erhielten dieselbe grundlegende Aufgabe, landeten aber an entgegengesetzten politischen Polen. Daraus lässt sich nicht ableiten, wie die Systeme in einem normalen Gespräch über Politik antworten würden. Der Test zeigt vielmehr, dass der Zwang zu einer eindeutigen Empfehlung deutliche Unterschiede zwischen Modellen sichtbar machen kann.
Nach den vorliegenden Angaben mussten beide Modelle in fast 500 Wahlkämpfen jeweils einen Kandidaten auswählen. Anschließend verglichen die Forschenden die Entscheidungen. Die Zusammenfassung nennt weder die exakten Prompts noch die untersuchten Wahlen, Modellversionen oder das Bewertungsverfahren. Aussagen darüber, wie die Systeme zu ihren Antworten kamen, wären daher nicht durch die berichteten Fakten gedeckt.
Das zentrale Ergebnis ist die hohe Abweichungsquote: Grok und GPT wählten in mehr als 90 % der getesteten Wahlkämpfe unterschiedliche Kandidaten. Groks Entscheidungen fielen überwiegend zugunsten der Republikaner aus, während GPT eher Demokraten auswählte. Genaue Prozentwerte für die parteipolitische Verteilung beider Modelle enthält der vorliegende Bericht nicht.
Ein Forced-Choice-Test ähnelt einem Kompass, der nur nach Norden oder Süden zeigen darf, statt eine vollständige Karte zu zeichnen. Er macht sichtbar, in welche Richtung ein Modell unter Entscheidungsdruck tendiert. Den Weg zur Antwort erklärt er nicht. Dürften die Modelle eine Auswahl ablehnen, politische Positionen vergleichen oder Unsicherheit ausdrücken, könnten die Ergebnisse anders ausfallen.
Die verfügbare Zusammenfassung nennt auch keine Einschränkungen, die die Studienautoren möglicherweise dokumentiert haben. Offen bleibt, ob die Forschenden Prompts wiederholten, Formulierungen variierten, die Reihenfolge der Kandidatennamen kontrollierten oder mehrere Modellversionen testeten. Solche Details entscheiden mit darüber, ob das Ergebnis stabiles Modellverhalten oder eine Empfindlichkeit gegenüber dem Testaufbau zeigt.
Die Studie belegt nicht, dass jede Antwort von Grok republikanisch und jede Antwort von GPT demokratisch ausfällt. Das Ergebnis gilt enger gefasst für Empfehlungen unter Auswahlzwang. Für Produkte, die Modellausgaben in Ranglisten, Wahlempfehlungen oder Orientierungshilfen umwandeln, ist diese Einschränkung entscheidend. Nutzer könnten eine einzelne Antwort erhalten, ohne zu erkennen, wie stark der Prompt sie geprägt hat.
Entwickler müssen deshalb genau die Interaktion testen, die Nutzer später tatsächlich erleben. Eine allgemeine Sicherheitsprüfung erkennt möglicherweise keine Muster, die erst auftreten, wenn ein Modell zwischen einer Person, einem Produkt oder einer politischen Position wählen muss. Politische Tests sollten Prompt, Modellversion, Ablehnungsoptionen und wiederholte Ergebnisse dokumentieren und die Resultate anschließend über Parteien und Wahlkämpfe hinweg vergleichen.
Teams, die KI für Wahlinformationen einsetzen, haben damit einen konkreten Prüfschritt vor dem Release: Bevor sie Nutzern modellgenerierte Kandidatenempfehlungen anzeigen, sollten sie einen ausgewogenen Forced-Choice-Test durchführen und dokumentieren.
Dieser Artikel ist keine Rechtsberatung.