Meta представи Muse Ember на 9 ноември 2026 г. и го описва като най-малкия и най-ефективния си модел, създаден за работата, която агентите повтарят през целия ден: извиквания на инструменти, подзадачи в кода, маршрутизиране, извличане и разбор на дълги документи.
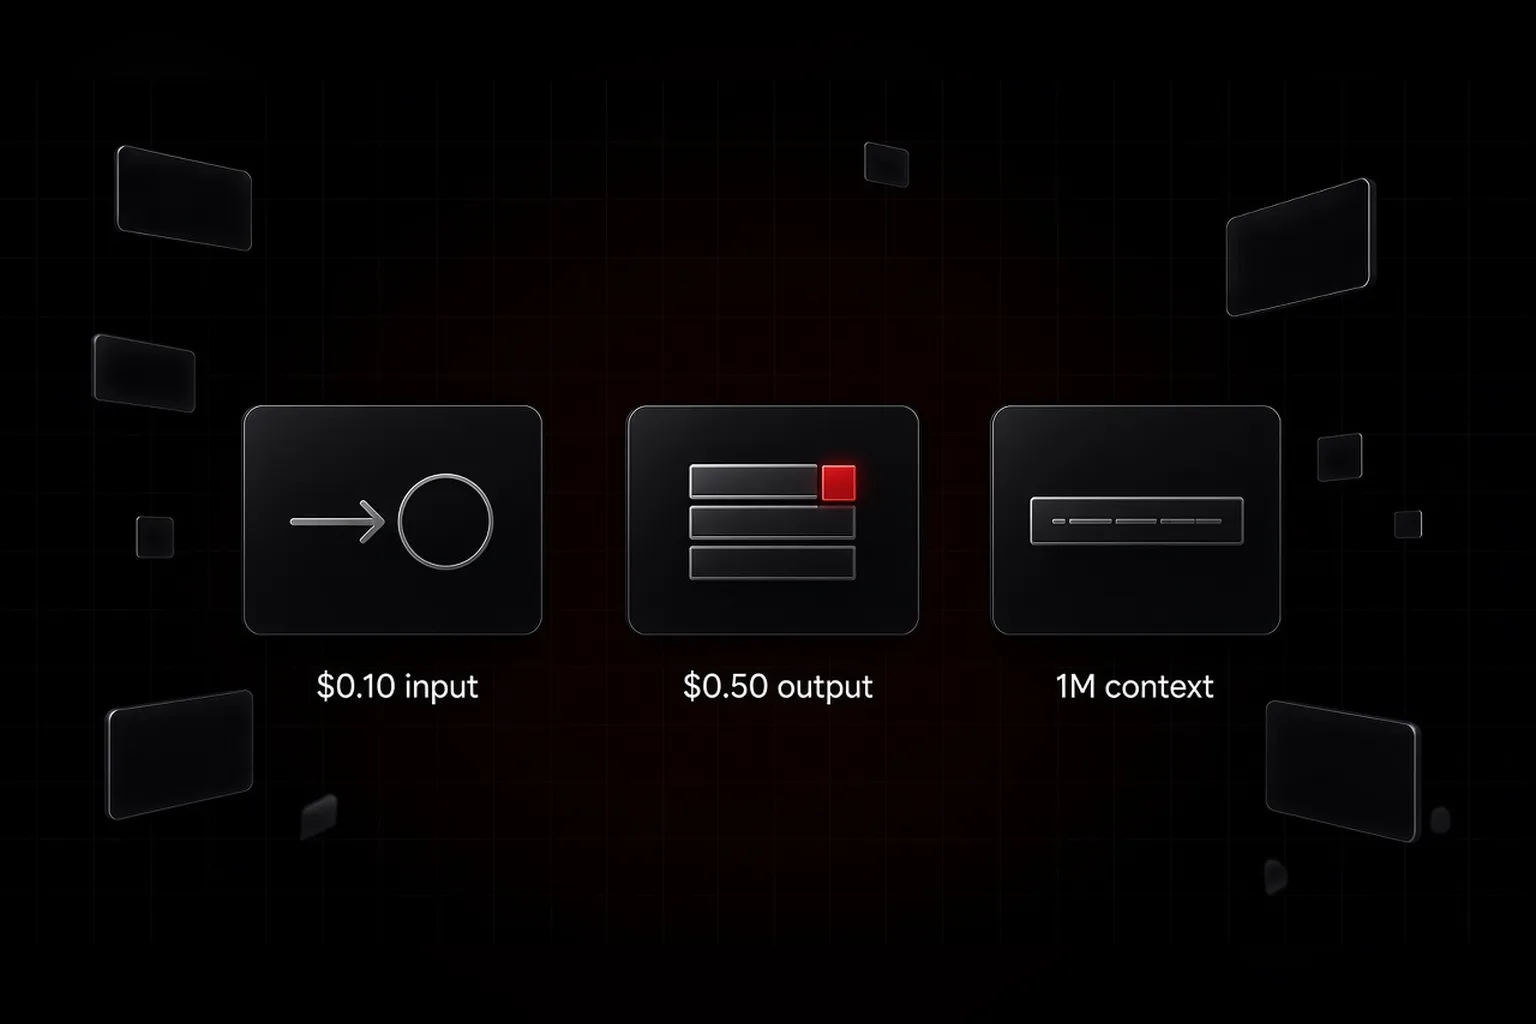
Моделът е достъпен в Muse Code и в Meta Model API като muse-ember-1.0, а Meta казва, че Muse Ember, Muse Spark и Muse Wonder вече са достъпни в Google Cloud и Oracle Cloud. Цената по списък за подсказки до 200K токена е 0,10 долара за милион входни токена, 0,004 долара за милион кеширани входни токена и 0,50 долара за милион изходни токена. За по-дълги подсказки цената е 0,30, 0,012 и 1,50 долара. Контекстният прозорец е 1 милион токена, с до 512K изходни токена. Muse Ember поддържа Responses API.
Meta поставя Ember на границата на ефективността в класацията на Artificial Analysis и твърди, че дава повече интелигентност на долар от Claude Haiku 5.5 или GPT-6 Luna при всяка настройка на разсъждение, като достига най-добрия резултат на Haiku на около една трета от цената. Посочва се цена около 0,14 долара на задача в Artificial Analysis при цени по списък. Тези сравнения използват данни от Artificial Analysis Intelligence Index v5, публикувани на 9 ноември 2026 г., заедно със собствени оценки на Meta, и трябва да се четат като сметка на Meta.
Сред числата, които Meta съобщава при максимално разсъждение: 37,8% в AutomationBench-AA, 61,6% в Agents' Last Exam (подмножество Linux на Meta), 40,9% в Terminal-Bench 4.0 в най-добрия публикуван harness на Ember и 36 в индекса на Artificial Analysis, наравно с Haiku 5.5 при максимум и пред 28 на GPT-6 Luna. В FrontierCode 2.0-AA Haiku 5.5 води с 34,9% срещу 27,2% за Ember.
Meta казва, че е оценила Ember по своята рамка Superintelligence Scaling Framework, включително химически и биологични рискове, киберсигурност и риск от загуба на контрол, и че Ember е останал под праговете за висок риск на рамката. Ember е първият специализиран модел, който според Meta е обучен с Muse Wonder Full. Компанията поставя Wonder за най-трудните проблеми, Spark за код и агентни процеси и Ember за повтарящи се задачи в мащаб.
Защо това е важно
Цената по списък е достатъчно ниска, че екипите могат да въртят отделен работен модел до по-голям плановик. Прагът 200K има значение: по-дългите подсказки утрояват цените за вход и изход. Водещите места в тестовете са на Meta, а в FrontierCode 2.0 Ember не е първи, така че проверка върху реалните подзадачи решава дали 0,10 и 0,50 долара са правилната двойка.
Източници: съобщение на Meta.
Тази статия не е правен съвет.